Vercel introduz Virtual Models no AI Gateway para trocar modelo de IA sem redeploy

- Leitura
- 7 min
- Tabelas
- 1
- Código
- 3
- Fontes
- 1
Nova camada do AI Gateway separa o ID de modelo usado no código da configuração real por trás dele, permitindo trocar modelo, fallback e políticas de retenção sem deploy.
A Vercel apresentou os Virtual Models no AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → Gateway, uma camada que desacopla o nome do modelo usado em produção da configuração real por trás dele. Na prática, isso muda onde times de engenharia guardam decisões que hoje vivem espalhadas pelo código.
A Vercel apresentou os Virtual Models no AI Gateway, uma camada que desacopla o nome do modelo usado em produção da configuração real por trás dele. Na prática, isso muda onde times de engenharia guardam decisões que hoje vivem espalhadas pelo código.
A Vercel anunciou em seu blog oficial os Virtual Models, uma nova camada do AI Gateway que separa o identificador de modelo usado no código da configuração real que roda por trás dele. Em vez de apontar uma chamada de IA para anthropic/claude-opus-5.5 diretamente, o time passa a apontar para um ID como vmc/coding-agent, e decide em outro lugar qual modelo, fallback e política de retenção esse ID representa.
É uma mudança de arquitetura pequena no papel, mas que ataca um problema real de quem roda agentes de IA em produção: a velocidade com que os modelos mudam já não acompanha o ciclo de deploy do app que os consome.
O problema: trocar modelo ainda significa redeploy
O AI Gateway da Vercel já tratava a troca de modelo como uma mudança de uma linha só: o desenvolvedor edita a string do modelo no código, e o Gateway cuida de rotear a chamada para um provedor saudável, com fallback automático se um deles falhar. Segundo a Vercel, nos últimos 90 dias 125 novos modelos de mais de 10 laboratórios diferentes ficaram disponíveis no Gateway, uma média de cerca de 10 por semana.
O atrito não estava em decidir trocar de modelo, estava em propagar essa troca. Uma linha de código ainda é uma linha de código: ela vive num repositório, passa por revisão, precisa de build e termina em redeploy. Para um time que roda dezenas de agentes e tarefas diferentes, cada troca de modelo virava um ciclo de CI/CD↳CI/CD23 conteúdosCI/CD Mobile: o caos invisível que separa times comuns de times de alta performanceDev (Back & Front) · abr 2026Lambda: implementando com GitLab CI/CD e Terraform para Integração SFTP, S3 e Databricks em GoDev (Back & Front) · nov 2023Publicando sua aplicação Web Python no WebApp do Azure e configurando o CI/CD da sua aplicaçãoDevSecOps · abr 2019Ver tudo em DevSecOps → inteiro só para atualizar uma string.
Em resumo: os Virtual Models tiram essa string do código e colocam num painel (ou na CLI) do AI Gateway. O app continua chamando sempre o mesmo ID; quem muda o modelo por trás dele é configuração, não deploy.
Como funciona na prática
A criação de um virtual model acontece pela Vercel CLI ou pelo dashboard do time. O comando abaixo cria o ID coding-agent, aponta para um modelo específico da Anthropic e já liga Zero Data Retention:
vercel ai-gateway virtual-models create coding-agent \
 --model anthropic/claude-opus-5.5 \
 --config '{"speed":"fast","zeroDataRetention":true}'
No código da aplicação, o que muda é só a string passada como model para o AI SDK, que agora usa o prefixo vmc/ (virtual model config) em vez do par provedor/modelo:
import { streamText } from 'ai';

const result = streamText({
 model: 'vmc/coding-agent',
 prompt: 'Remove the deprecated API calls from this module.',
});
Quando um modelo melhor ou mais barato aparece, o time edita o virtual model, não o código:
vercel ai-gateway virtual-models edit coding-agent --model openai/gpt-6.1-solSegundo a Vercel, todo app e agente que chama vmc/coding-agent passa a usar o novo modelo em poucos minutos, sem alteração de código nem novo deploy. Isso vale também para harnesses de coding agent como Claude Code e Codex: depois de rodar vercel ai-gateway setup, basta selecionar o virtual model no seletor de modelo de cada ferramenta.
Um ID por tarefa, não um ID por app
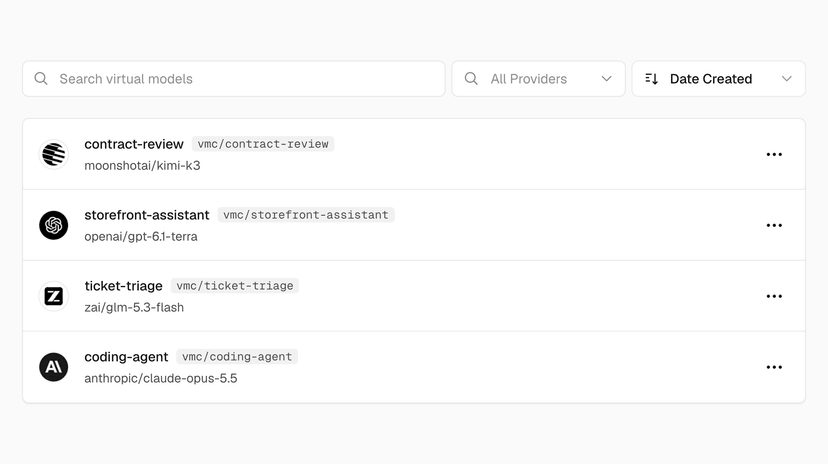
O recorte que a Vercel propõe não é "um virtual model por aplicação", é um virtual model por tarefa. A lógica é simples: triagem de ticket de suporte roda centenas de vezes por hora e precisa ser barata; revisão de contrato jurídico roda poucas vezes por dia e exige raciocínio mais caro. Cada tarefa ganha seu próprio ID, com modelo e configuração dimensionados para o que ela realmente precisa:
| Virtual model | Uso | Configuração destacada |
|---|---|---|
vmc/coding-agent | Agente de código (Claude Code, Codex, apps internos) | Modo rápido, Zero Data Retention obrigatório |
vmc/ticket-triage | Triagem de suporte em alto volume | Provedores ordenados por custo |
vmc/storefront-assistant | Assistente de loja, latência sensível | Ordenado por tempo até o primeiro token, com fallback definido |
vmc/contract-review | Revisão de contrato jurídico | Esforço de raciocínio alto, Zero Data Retention obrigatório |
Fallback, Zero Data Retention e tags ficam amarrados ao virtual model, não ao modelo específico. Trocar o modelo por trás de um virtual model mantém essas políticas; o que muda são as opções específicas do provedor anterior, que deixam de se aplicar e precisam ser revisadas manualmente. Segundo a Vercel, por exemplo, uma configuração específica da Anthropic deixa de valer quando o virtual model passa a apontar para um modelo da OpenAI, e por isso vale revisar as opções de provedor sempre que a troca envolver provedores diferentes.
A Vercel recomenda um caminho de validação antes de trocar um virtual model que já serve tráfego de produção: criar um segundo ID, como vmc/coding-agent-candidate, apontar para o novo modelo, rodar os evals do time contra ele e só então promover a troca para o ID original. Se a qualidade cair depois da virada, o caminho de volta é apontar o ID de novo para o modelo anterior, sem precisar reverter nenhum deploy.
Governança: quem decide o que o time chama
Qualquer pessoa do time pode chamar um virtual model pelo ID, mas papéis de equipe controlam quem pode alterar a configuração por trás dele. Isso dá a plataformas e times de segurança um ponto único de controle: liberar acesso a modelos novos para todo mundo, mas manter a decisão de qual modelo roda de fato nas mãos de quem responde por custo e compliance.
O desenho de precedência é o detalhe mais importante para quem roda isso em produção: configurações do virtual model sempre vencem configurações da requisição individual. Um app não consegue sobrescrever a ordem de provedores, o fallback ou o tier de serviço definidos centralmente, mesmo que tente especificar outra coisa na chamada.
O mesmo vale para retenção de dados: se um virtual model exige Zero Data Retention ou provedores que não treinam com os dados da requisição, essa exigência é mantida mesmo que uma chamada específica tente desligar zeroDataRetention ou disallowPromptTraining. Tags seguem a mesma regra, substituindo qualquer tag enviada pela aplicação, de forma que o gasto e o volume de cada tarefa aparecem corretamente na página de Virtual Models, independentemente de como cada app rotula suas próprias chamadas.
O que isso substitui e onde ainda mora o limite
Virtual Models não substituem o AI Gateway, eles são uma camada em cima dele: a cobrança continua refletindo o preço do provedor, sem markup e sem taxa de plataforma sobre inferência, inclusive em chamadas BYOK (Bring Your Own Key). O recurso funciona com todo tipo de modelo suportado pelo Gateway, incluindo imagem, vídeo, fala, embedding e modelos de tempo real, e é compatível com o AI SDK e com as APIs compatíveis com OpenAI e Anthropic.
O ganho real é operacional, não de performance de modelo: times que já centralizam modelo e configuração num serviço próprio de feature flag ou num proxy interno ganham pouco adicionando mais uma camada de abstração da Vercel por cima. Onde o recurso compensa é no cenário oposto, comum em squads menores ou em produtos com muitos agentes: strings de modelo espalhadas por dezenas de arquivos, sem padrão de fallback, sem visibilidade central de gasto por tarefa.
Vale também notar o que o recurso não resolve sozinho: trocar o modelo por trás de um virtual model não garante que o prompt e o comportamento do agente continuem bons com o novo modelo. O próprio fluxo de validação sugerido pela Vercel (ID candidato, rodar evals, só então promover) deixa claro que a responsabilidade por qualidade de resposta continua do lado de quem escreve o prompt e os testes, não do lado da infraestrutura de roteamento.
Fonte: Vercel Changelog
Este artigo foi escrito por Carina Ferreira, colunista de front-end. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

Kimi K3.1 Pro chega ao AI Gateway da Vercel com contexto de 1M de tokens e pesos abertos a caminho
A Vercel adicionou o Kimi K3.1 Pro e a variante Highspeed ao AI Gateway, modelo da chinesa Moonshot AI com foco em coding, 1 milhão de tokens de contexto e pesos que devem abrir até 4 de novembro.