GitHub Copilot Fusion automatiza a escolha de modelo de IA no código

- Leitura
- 5 min
- Fontes
- 1
O recurso virou padrão geral no GitHub Copilot em 28 de outubro de 2026 e substitui a escolha manual entre Claude, GPT-4 e outros modelos por um sistema que decide sozinho, tarefa a tarefa.
O fim da escolha manual de modelo
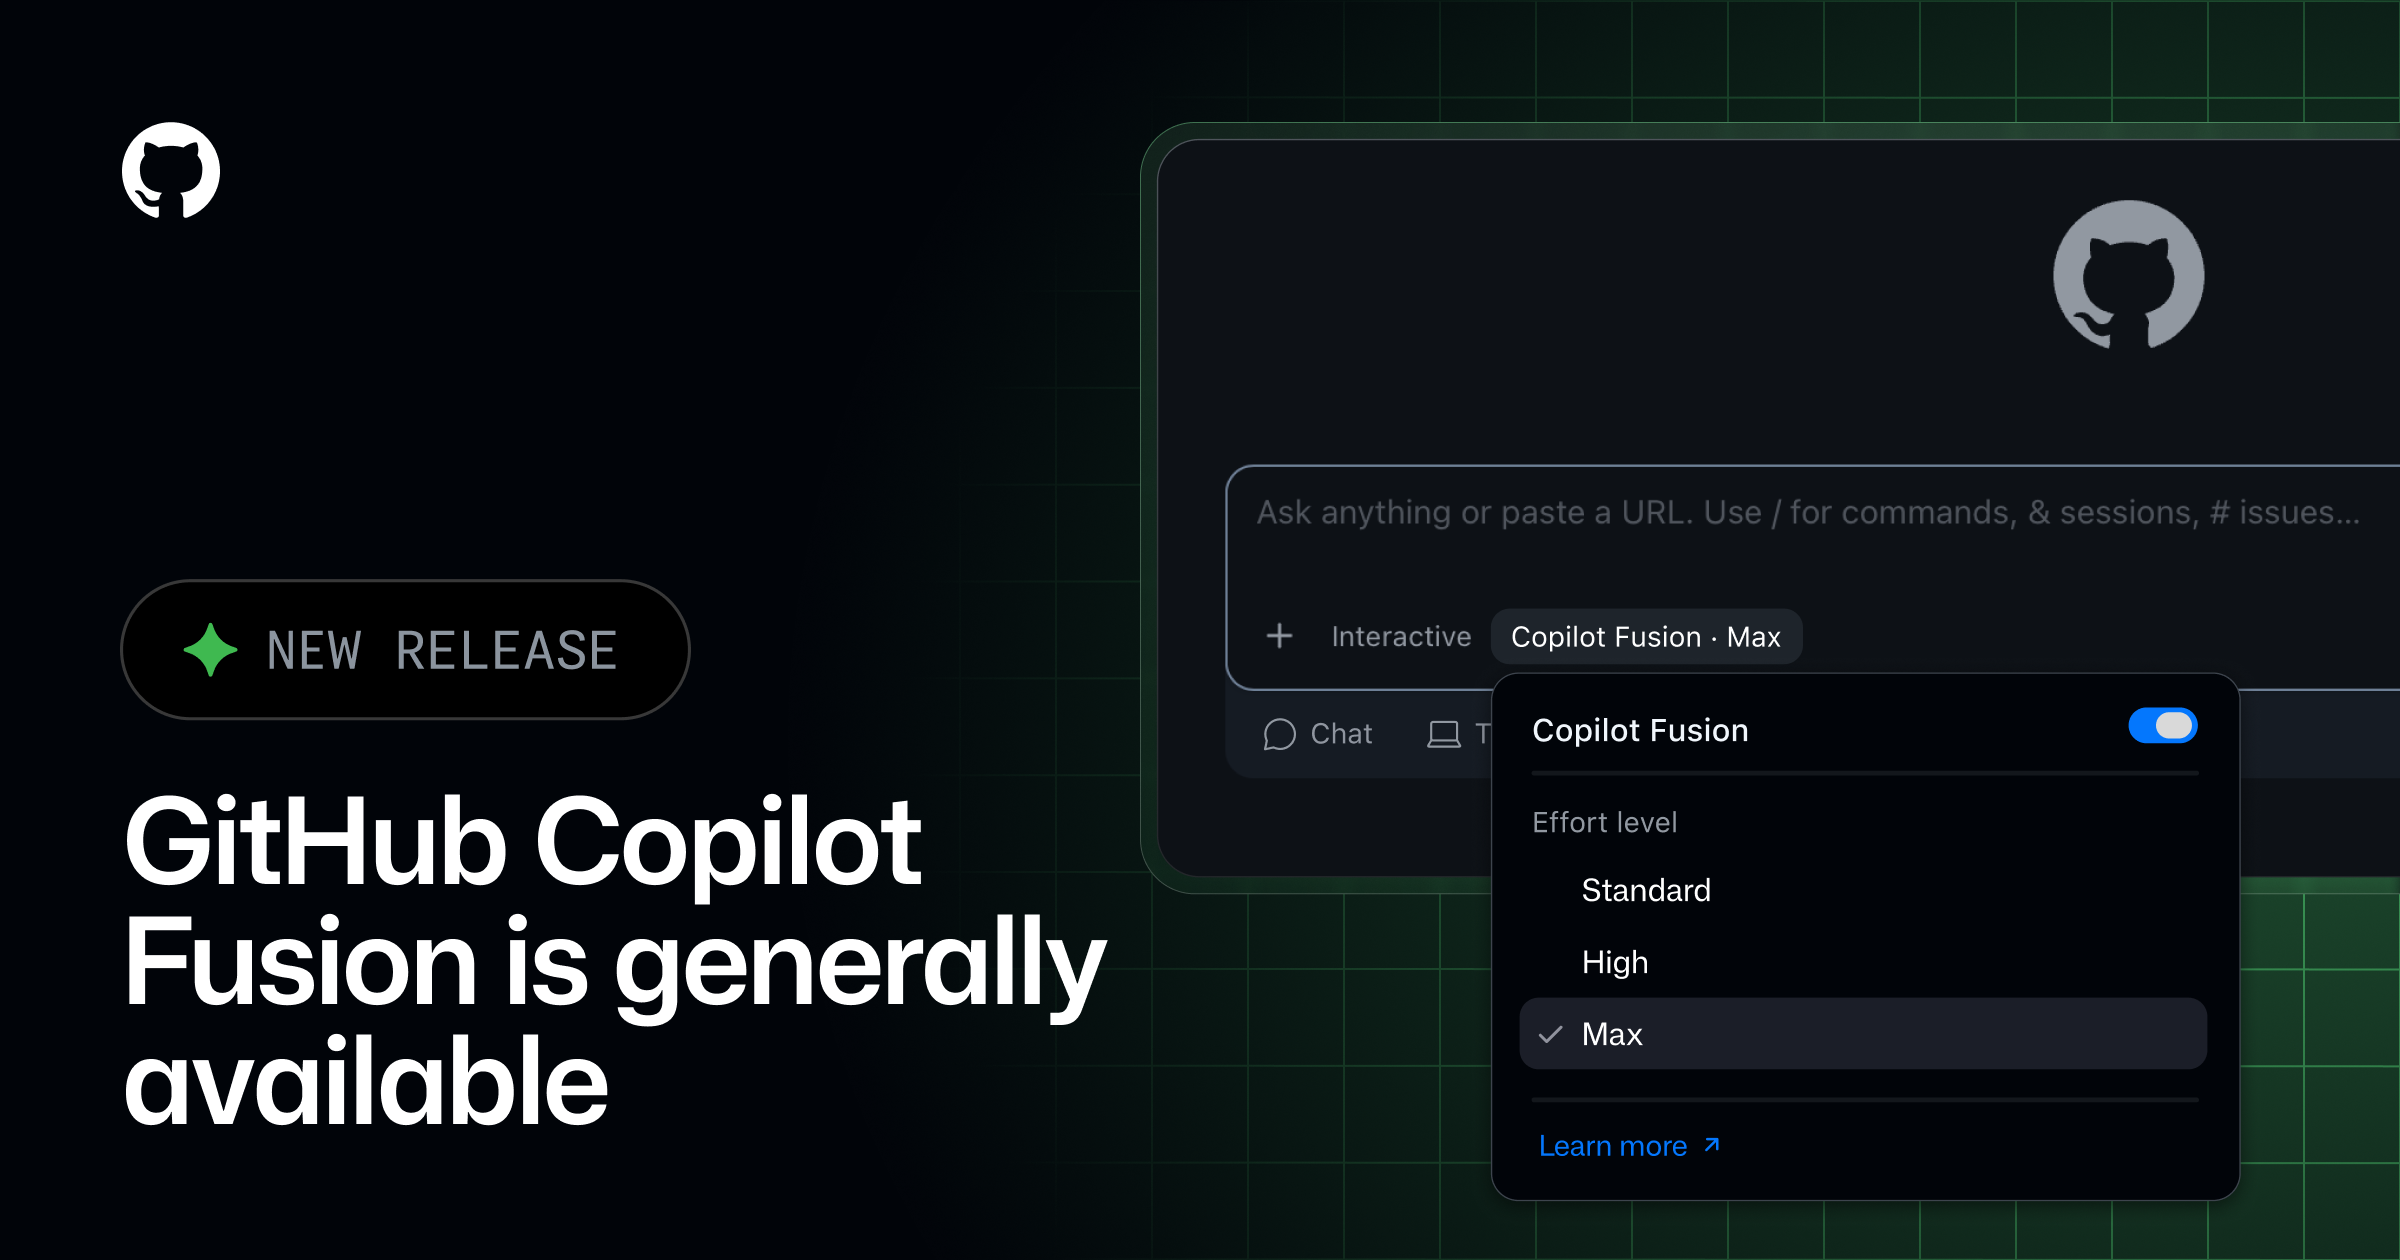
O GitHub tornou geral o Copilot Fusion em 28 de outubro de 2026, segundo o changelog oficial do GitHub. Antes, quem usava o Copilot no VS Code precisava abrir o seletor de modelos e decidir, tarefa a tarefa, se o trabalho pedia Claude, GPT-4 ou outro modelo disponível no plano. Com o Fusion, essa escolha some do fluxo: o dev seleciona Copilot Fusion no seletor e o sistema decide, a cada prompt, qual modelo (ou combinação de modelos) resolve melhor aquele pedaço de código.
O recurso não nasceu do zero. Ele junta duas coisas que já existiam em preview: o Project HydraFusion, que orquestrava múltiplos modelos numa mesma tarefa, e o Copilot auto model selection, que escolhia um único modelo por tarefa. A fusão das duas abordagens tenta equilibrar duas métricas que sempre competem entre si: qualidade da resposta e custo por tarefa.
Quem já usava as versões em preview (auto, HydraFusion ou HydraFusion Max) teve a própria configuração migrada automaticamente para o nível de esforço correspondente do Fusion. Não é preciso reconfigurar nada manualmente para continuar usando o recurso.
Três níveis de esforço, três fluxos de trabalho
Ao escolher Copilot Fusion no seletor, o dev ainda define um nível de esforço:
- Fusion Standard: prioriza modelos versáteis para o dia a dia, tipo autocompletar uma função ou escrever um teste simples.
- Fusion High: prioriza modelos mais capazes para tarefas difíceis e raciocínio mais profundo.
- Fusion Max: usa os modelos mais capazes disponíveis, reservado para as tarefas mais exigentes.
Por baixo, o Fusion decide entre três estratégias de orquestração para cada prompt:
- Single: um modelo resolve a tarefa sozinho, sem ajuda.
- Cascade: um modelo mais barato rascunha a resposta; um checador de qualidade decide se aceita ou escala para um modelo mais forte.
- Critique: um modelo rascunha, outro modelo revisa, e o primeiro reescreve com base na crítica.
Essa orquestração é o que distingue o Fusion de um simples modelo padrão automático: dentro de uma única tarefa, dois ou três modelos diferentes podem trabalhar em sequência sem que o dev perceba a costura entre eles.
Os números que o GitHub divulgou
No Artificial Analysis Coding Agent Index, benchmark de terceiros citado pelo próprio changelog, o Fusion Max marcou 60 pontos, a dois pontos do Claude Code rodando com Opus 5.5 Max. A diferença, segundo o GitHub, está no custo: o Fusion Max chegou a esse resultado gastando cerca de metade do custo médio de API por tarefa, usando cerca de metade dos tokens e levando cerca de 40% menos tempo por tarefa.
Vale um parêntese de ceticismo saudável: esses números vêm de um benchmark mencionado pelo próprio fornecedor, sem link direto, no changelog, para a metodologia completa ou para resultados reproduzíveis por terceiros. É um dado real, mas que merece validação em testes próprios antes de virar argumento de ROI para o time.
O que muda pra quem escreve código todo dia
Na prática, a mudança mexe com um hábito comum que o próprio GitHub cita como motivação: trocar o modelo para uma tarefa complexa e esquecer de voltar ao modelo mais barato depois. Esse hábito, documentado via depoimento de um cliente real, é exatamente o tipo de fricção que o Fusion tenta eliminar.
O Copilot Fusion Standard melhorou a eficiência de tokens em toda a AT&T ao selecionar automaticamente o modelo certo para a tarefa, reduzindo gasto desnecessário e preservando capacidade para trabalho de maior valor.
Hari Pokhrel, Principal Software Engineer, AT&TGitHub Copilot Fusion Standard has improved token efficiency across AT&T by automatically selecting the right model for the task, reducing unnecessary spend and preserving capacity for higher-value work.
É o único caso de uso em produção que o changelog cita nominalmente. A fonte não menciona nenhuma empresa brasileira adotando o Fusion; quem trabalha em equipes daqui que já usam Copilot Enterprise vai precisar testar por conta própria se o mesmo padrão de economia de tokens se repete no volume de tarefas do time local.
O trade-off que fica escondido
Ganhar automação custa visibilidade. Quando o dev escolhia o modelo manualmente, sabia exatamente qual IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → gerou cada sugestão, o que importa para depurar um resultado estranho ou reproduzir um comportamento específico. Com o Fusion, essa decisão passa a ser do sistema, tarefa a tarefa, e o changelog não detalha se a interface mostra, depois do fato, qual modelo (ou combinação) foi usado em cada resposta.
Isso pesa mais em times com políticas de compliance sobre qual provedor de modelo processa qual tipo de código. Administradores continuam no controle: o Fusion só usa os modelos habilitados nas políticas de modelo da organização e da enterprise, e dá para desabilitar um modelo específico só para o Fusion sem tirá-lo do catálogo geral. Também dá para configurar o Fusion, em qualquer nível de esforço, como modelo padrão via enterprise managed settings.
Como fica a cobrança
O Fusion não é um plano à parte: o uso é cobrado por modelo, na tarifa padrão de cada modelo envolvido na tarefa. Por tempo limitado, quem está em planos pagos do Copilot recebe 30% de desconto no custo de modelo ao usar o Fusion, o que ajuda a justificar a troca nos primeiros meses, mas vale lembrar que desconto promocional tem prazo de validade que o changelog não especifica.
Quando vale a pena trocar
Faz sentido ativar o Fusion nas tarefas do dia a dia, naquelas que o próprio dev não teria paciência de categorizar manualmente entre simples e complexa antes de cada prompt. Também faz sentido para quem lidera um time e quer parar de perder orçamento com gente usando modelo caro para tarefa trivial, que foi exatamente o problema relatado pela AT&T.
Não faz tanto sentido quando a tarefa pede um modelo específico por razão técnica conhecida, tipo janela de contexto maior, afinidade comprovada com uma linguagem de nicho, ou quando o time precisa de rastreabilidade determinística de qual modelo gerou qual trecho de código para fins de auditoria. Nesses casos, escolher o modelo manualmente continua sendo a opção mais segura, ao menos até o GitHub detalhar melhor como o Fusion expõe essa informação depois da geração.
O Copilot Fusion está disponível em todos os planos do Copilot no VS Code, no app GitHub Copilot, na GitHub Copilot CLI e nas IDEs JetBrains, com suporte a outros clientes prometido para os próximos meses.
Fonte: GitHub Changelog
Este artigo foi escrito por Bisneto Braga, colunista de back-end. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

PHP 8.5 adiciona pipe operator nativo: o que muda para quem mantém monolito em produção
Disponível desde novembro de 2025, o operador |> troca encadeamentos aninhados por uma leitura de cima para baixo. Mas ele só resolve parte do problema de legibilidade que existe em bases PHP antigas.